Breve historia de la voz sin cuerpo, de 1939 a mañana
Durante casi un siglo hemos intentado separar la voz del cuerpo que la produce. Lo que empezó como una proeza técnica ha terminado convirtiéndose en una pregunta sobre quién habla cuando escuchamos una voz.
1. 1939: dos futuros para la voz
La Feria Mundial de Nueva York se había levantado en Flushing Meadows, un antiguo vertedero de cenizas de Queens, y se anunciaba con una modestia muy propia del siglo XX: The World of Tomorrow, el Mundo del Mañana. Coches, electrodomésticos, autopistas, telecomunicaciones. El futuro llegaba repartido por pabellones y parecía convencido de que casi cualquier problema humano acabaría resolviéndose con suficiente electricidad.
En el de AT&T, una mujer hacía hablar a una máquina sin abrir la boca.
Helen Harper se sentaba frente a una consola con teclado, una barra que accionaba con la muñeca y un pedal. No había una grabación escondida ni nadie esperando al otro lado de la línea. Cuando empezaba a mover las manos y el pie, de un altavoz salían palabras. La máquina se llamaba Voder.
Bell Labs la había desarrollado a partir de las investigaciones de Homer Dudley sobre síntesis de habla. Harper era su principal operadora y ayudó a formar a una veintena de mujeres capaces de manejarlo. Aprender exigía cerca de un año. Para demostrar lo difícil que era, Harper utilizaba una palabra: concentration. Pronunciarla obligaba a encadenar trece sonidos y coordinar varios movimientos de muñeca y pedal.
No era exactamente hablar y tampoco era exactamente tocar un instrumento. Era interpretar un aparato vocal que no existía. El Voder no reproducía una voz: la fabricaba. No había una garganta escondida en alguna parte ni una persona cuya voz estuviera siendo transformada. Producía la voz de nadie.
Pero 1939 encontró también el camino contrario.
Alvino Rey experimentaba con una steel guitar que parecía hablar. Un micrófono de garganta colocado sobre el cuello de su esposa, Luise King, recogía las articulaciones que ella realizaba oculta detrás de una cortina. El público veía una guitarra; la boca permanecía fuera de plano.
Ese mismo año, Gilbert Wright hizo otro descubrimiento menos solemne. No se había afeitado y se rascaba la barba sobre la nuez cuando percibió que aquel ruido parecía salirle por la boca. Probó a articular palabras en silencio y se entendían. De ahí surgió el Sonovox, unos transductores aplicados al cuello que permitían usar la boca y la garganta para moldear un sonido procedente de fuera. Disney acabaría usándolo para dar voz al tren Casey Jr. en Dumbo.
El futuro de la voz se bifurcó casi desde el principio. En Nueva York, la máquina intentaba librarse del cuerpo. En la costa oeste, necesitaba meterse dentro de él.
2. Desmontar una garganta
Para llegar al Voder hay que retroceder una década.
Homer Dudley empezó a trabajar en el vocoder en Bell Labs en 1928 porque los cables transatlánticos planteaban un problema menos espectacular que hacer hablar una máquina: tenían un ancho de banda limitado y transportar voz salía caro.
Dudley buscó una manera de no transportar la voz entera. El vocoder analizaba determinadas características del habla y enviaba las señales necesarias para reconstruirla al otro lado. En lugar de transmitir cada vibración producida por una garganta, transmitía algo parecido a sus instrucciones de montaje.
La voz se había vuelto desmontable: podía desaparecer en un extremo de la línea, viajar reducida a información y reaparecer en el otro. El Voder aprovechaba la parte sintetizadora de aquella investigación. Si una máquina era capaz de reconstruir habla a partir de unas instrucciones, también podía producirla sin que existiera una voz original.
La Feria Mundial convirtió una solución para las telecomunicaciones en espectáculo. Cuatro años después, la guerra encontró otra aplicación.
Desde 1943, las conversaciones de los dirigentes aliados cruzaron el Atlántico protegidas por SIGSALY, un sistema que utilizaba el vocoder de Dudley como parte de su funcionamiento. Uno de sus terminales se encontraba en el sótano de Selfridges, en Oxford Street, y entre su enorme equipamiento había dos giradiscos.
Arriba, unos grandes almacenes. Abajo, la guerra cifrada con discos.
Antes de llegar a los estudios de grabación, la voz electrónica ya había servido para ahorrar espacio, entretener a los visitantes de una feria y ocultar conversaciones que nadie más debía escuchar.
3. La máquina dentro de la boca
El talkbox eligió la otra rama de aquella bifurcación.
Su funcionamiento parece sofisticado hasta que se explica. El sonido de una guitarra o un sintetizador se envía por un tubo de plástico que termina dentro de la boca del músico. Allí, lengua, dientes, paladar y mejillas modifican físicamente la señal. Un micrófono situado delante recoge el resultado. El futuro, durante un rato, necesitó bastante saliva.
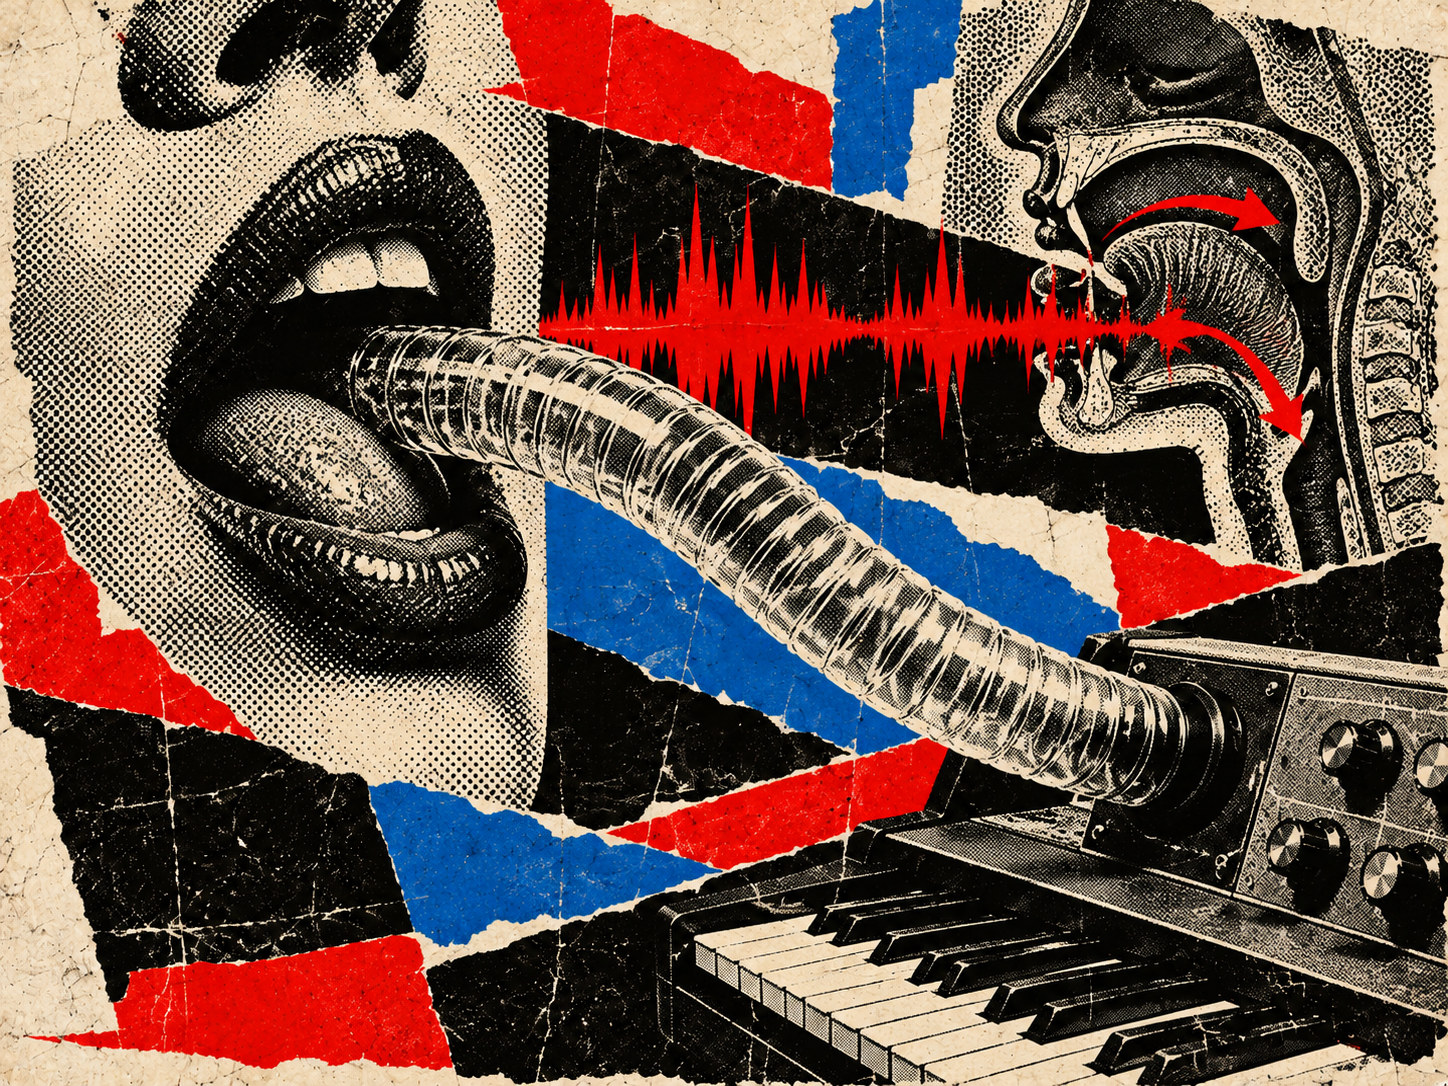
Roger Troutman convirtió esa rudimentaria fontanería sonora en una de las voces más reconocibles del funk. En 1980, para More Bounce to the Ounce, utilizó un talkbox conectado a un Minimoog. El sintetizador llegaba literalmente hasta su boca y allí dejaba de ser únicamente una señal eléctrica.
Troutman no usaba el aparato para desaparecer, sino al revés. Las sílabas se ensanchan, se doblan, bailan alrededor del ritmo. Lo tecnológico no enfría la interpretación: la vuelve extrañamente física. Cuesta olvidar que en algún punto del circuito hay dientes, lengua, respiración y un hombre intentando que el tubo no se le escape de la boca.
El talkbox necesita demasiado cuerpo para hacerlo desaparecer. La máquina lo usa como una habitación.
4. Frases útiles para el futuro
Unos años antes, en Düsseldorf, Kraftwerk había tomado el camino contrario.
En Radio-Aktivität, de 1975, la voz procesada ya no aparecía simplemente como efecto. En «Die Stimme der Energie», la propia energía parecía haber encontrado una voz para presentarse al mundo.
Algunos de los sonidos más reveladores llegarían después, y por un camino mucho menos monumental. Las voces de Computer World no surgieron de una misteriosa computadora construida en Düsseldorf. Kraftwerk utilizó también un Language Translator de Texas Instruments, un pequeño aparato concebido para viajeros que ofrecía traducciones y frases útiles en varios idiomas.
Kraftwerk estaba haciendo canciones sobre ordenadores, datos, números e identidad en la nueva sociedad informatizada con el vocabulario sonoro de un manual de conversación para hombres de negocios.
La voz del futuro venía de la sección de frases útiles.
Para buena parte del público, las diferencias entre vocoder, síntesis de habla y otros procesadores acabaron importando menos que el efecto común: una voz podía conservar las palabras y, al mismo tiempo, perder algunas de las pistas que permitían imaginar el cuerpo que había detrás.
Con Troutman, la máquina convertía la boca en espectáculo. Con Kraftwerk, empezábamos a acostumbrarnos a no necesitar verla.
5. El error que decidió quedarse
Auto-Tune nació precisamente para que nadie reparara en la máquina.
Andy Hildebrand había trabajado años en Exxon procesando señales sísmicas. Las técnicas matemáticas que servían para detectar patrones en los ecos del subsuelo podían aplicarse también a otra clase de vibración: una nota cantada. Las matemáticas que habían buscado petróleo acabaron afinando voces.
Auto-Tune llegó al mercado como una herramienta correctiva. Si un cantante se desviaba ligeramente de una nota, el programa podía colocarla en su sitio sin dejar huellas aparentes.
En 1998, Cher estaba grabando Believe y quería que su voz se pareciera al efecto de vocoder que había escuchado en una canción de Roachford. Buscando aquel sonido, el productor Mark Taylor llevó Auto-Tune a un ajuste para el que, en principio, no había sido concebido. La transición natural entre unas notas y otras desapareció.
La voz dejó de deslizarse. Saltaba.
El error que el programa estaba diseñado para esconder se convirtió en el sonido que identificaba la canción.
Meses después, cuando Sound On Sound preguntó cómo lo habían conseguido, Taylor atribuyó el efecto a un DigiTech Talker, un dispositivo de tipo vocoder. No era cierto. Cher había pedido algo parecido a un vocoder, le habían hecho Auto-Tune y el resultado se presentó al mundo como vocoder.
La tecnología nueva entró en el pop disfrazada de la vieja. Después dejó de necesitar el disfraz.
Durante medio siglo habíamos querido que las máquinas hablaran como personas. Ahora queríamos oír a las personas sonar como si una máquina las hubiera tocado.
6. La voz de otro
A comienzos de los años sesenta, un ordenador IBM de Bell Labs cantó «Daisy Bell». Arthur C. Clarke escuchó aquella demostración durante una visita. Años después, cuando HAL 9000 es desconectado lentamente en 2001: Una odisea del espacio, la inteligencia de la máquina retrocede hacia uno de sus primeros recuerdos. Canta «Daisy Bell».
La primera vez que oí la voz de Stephen Hawking fue en Valladolid. Estaba solo en casa, hablando por el teléfono fijo, con la televisión encendida de fondo. De pronto, de la pantalla salió una voz plana, sin respiración, y pensé que estaba hablando un ordenador. Unos años después ya no lo pensaba: era la voz de Hawking. Durante todo ese tiempo di por hecho que aquella voz formaba parte de él, como la silla o la mirada. Nunca se me ocurrió preguntar de quién había sido antes.
Dennis Klatt llevaba años investigando en el MIT cómo conseguir que una máquina produjera habla comprensible. Perfect Paul, la más conocida de las voces surgidas de su trabajo, partía de la suya.
Una empresa llamada Speech Plus refinó aquella tecnología y la incorporó a un sintetizador, el CallText 5010. Uno de aquellos equipos acabó instalado en la parte posterior de una silla de ruedas en Cambridge: la de Stephen Hawking, que había perdido su voz natural después de una traqueotomía en 1985.
La tecnología siguió avanzando y aparecieron alternativas más naturales. Hawking prefirió conservar aquella voz. No quería una más convincente o más humana.
Quería aquella.
Dennis Klatt no llegó a saberlo. A mediados de los ochenta, mientras su voz empezaba a ser reconocida como la de otro, él estaba perdiendo la suya. Murió en 1988.
Con el tiempo, el hardware original fue imposible de mantener y hubo que emularlo mediante software, en un pequeño ordenador sujeto a la silla. La tecnología cambió; el timbre permaneció. Una voz que había comenzado en la garganta de un ingeniero estadounidense acabó formando parte de la identidad pública de un físico británico.
En 2007, Hatsune Miku complicó todavía más las cosas. Vocaloid permitía construir melodías cantadas mediante bancos de muestras vocales. La materia prima de Miku procedía de la actriz japonesa Saki Fujita, pero quien escuchaba aquellas canciones no oía a Saki Fujita, sino a Hatsune Miku.
Su nombre suele interpretarse como «el primer sonido del futuro». Sesenta y ocho años después del Mundo del Mañana de Flushing Meadows, el futuro tenía por fin una voz propia. Y procedía de una actriz cuyo nombre buena parte del público nunca necesitó conocer.
Miku tampoco era la voz de nadie. Era la voz de alguien convertida en la identidad de un personaje que no existía.
7. Palabras que nunca dijo
La inteligencia artificial llega tarde a esta historia. El Voder ya fabricaba habla sin hablante; la voz de Klatt ya se había convertido en la de Hawking; Saki Fujita ya había prestado la suya a alguien que no existía.
Pero detrás de cada una de esas voces había alguien vivo: una operadora con el pie en el pedal, un ingeniero que se escuchaba a sí mismo en un altavoz, una actriz que entró en un estudio a grabar sílabas.
En 2021, el documental Roadrunner, dedicado a Anthony Bourdain, cruzó otra frontera. Su director, Morgan Neville, quería que Bourdain pronunciara unas frases que había escrito pero de las que no existía grabación. Entregó horas de material sonoro a una empresa, que construyó un modelo de su voz. Tres fragmentos del documental se generaron de esa manera.
Bourdain había escrito aquellas palabras. Nunca las había pronunciado.
La revelación provocó polémica porque Bourdain había muerto en 2018 y ya no podía decidir qué se hacía con su voz. Neville afirmó que había consultado el procedimiento con personas cercanas a él y con su representante literario. Ottavia Bourdain, de la que estaba separado cuando murió, negó públicamente haber dado esa aprobación.
La clonación vocal actual reduce todavía más la distancia. Ya no hace falta construir durante años una voz nueva. A partir de grabaciones de una persona pueden generarse frases que nunca pronunció, con suficientes rasgos de su timbre, su ritmo y su entonación para que alguien la reconozca.
Una grabación conserva algo que ocurrió. Una voz clonada puede producir algo que no ocurrió nunca, con el timbre exacto de alguien que ya no puede negarlo.
En 1939, Helen Harper necesitó cerca de un año para conseguir que una máquina pronunciara correctamente concentration. Trece sonidos, varios movimientos de muñeca, un pie pendiente del pedal. Todo un cuerpo trabajando para fabricar una voz que no pertenecía a nadie.
Hoy basta con escribir.